
Prévoir la demande et dimensionner un stock de sécurité sans cacher l'incertitude
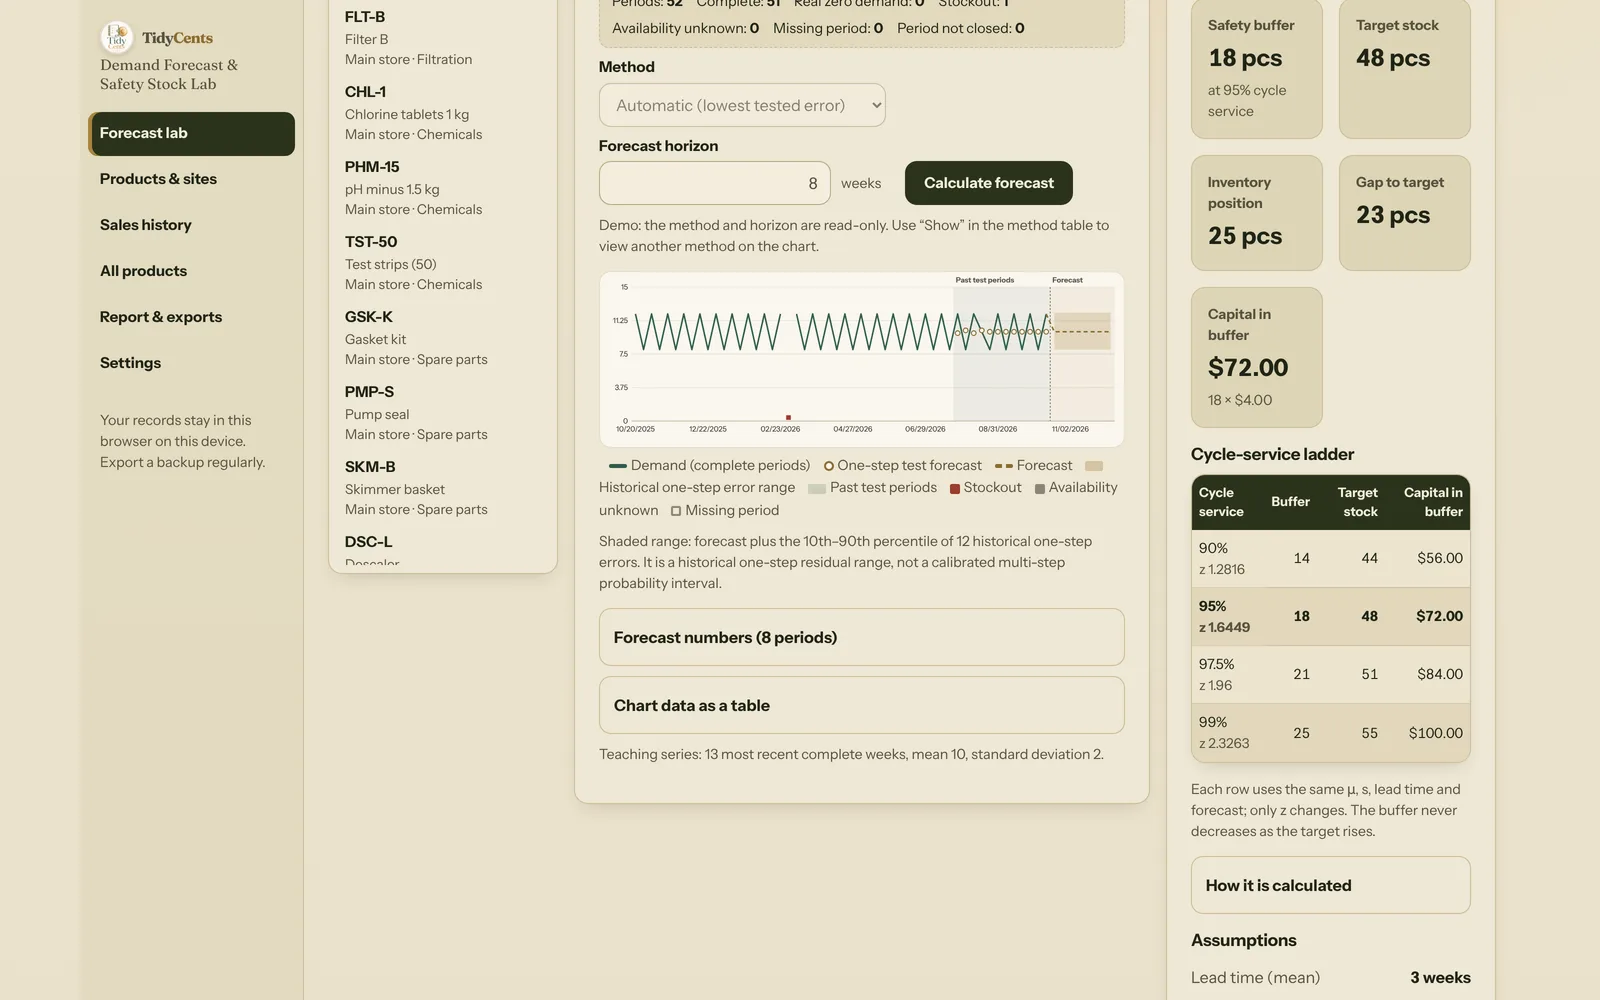
Un plan de stock commence par deux questions distinctes : quelle demande peut arriver et quel tampon vous êtes prêt à financer si la réalité diffère. Les fondre dans un seul point de commande inexpliqué cache précisément les hypothèses qui comptent. Dans l'exemple ci-dessous, un article qui se vend environ 10 unités par semaine obtient un stock de sécurité de 18 unités, un stock cible de 48, un écart de 23 unités jusqu'à cette cible — et 72 $ immobilisés dans le seul tampon. Chaque chiffre découle d'une hypothèse visible et modifiable.
Partir d'un historique exploitable
Une semaine de ventes réellement nulles est une information. Une semaine où l'article était indisponible ne prouve pas que personne n'en voulait. Si un filtre a été en rupture dès le mardi et que rien ne s'est vendu ensuite, noter « 0 » apprend à toute méthode de prévision que la demande a baissé — et le prochain stock sera trop faible là où vous avez déjà manqué.
Il faut donc marquer ces périodes à part :
- Période complète : l'article était disponible et la période est clôturée. Un zéro est ici un vrai zéro.
- Rupture : l'article était épuisé. La période est un trou, pas un zéro.
- Disponibilité inconnue : impossible à dire. C'est aussi un trou.
- Période ouverte : la semaine en cours. Elle est prévue, pas utilisée comme historique.
Les dates manquantes ne doivent pas non plus devenir des zéros en silence. Si l'export saute deux semaines parce que la caisse d'un magasin était hors ligne, ces semaines manquent ; elles ne sont pas « sans vente ». Et les retours ne sont pas une demande négative : corrigez d'abord l'historique source (par exemple en déduisant les retours de la semaine de la vente d'origine) et notez comment.
Dans la boutique fictive de la démo, un article a connu deux semaines de rupture et une semaine de disponibilité inconnue ces derniers mois. Sa dernière séquence continue de semaines complètes ne compte que 11 semaines : l'outil refuse donc d'en tirer un stock plutôt que de faire comme si les trous étaient des zéros.
Comparer des méthodes simples avant de compliquer
La dernière valeur, une moyenne mobile, le lissage exponentiel et une répétition saisonnière donnent des résultats très différents à partir du même historique. Pour choisir honnêtement, il faut tester les méthodes applicables sur les mêmes périodes passées, en n'entraînant chaque prévision que sur ce qui était connu avant sa date. Sinon, l'évaluation souffle la réponse à la prévision.
C'est ce que fait un test à origine glissante. On prend les 12 dernières semaines complètes (ou le quart de l'historique s'il est plus court, au minimum 4). Pour chacune, chaque méthode est ajustée sur les semaines précédentes et prévoit un pas en avant. On compare ensuite les écarts.
Pour l'article pédagogique de la démo, « Filtre A », avec 52 semaines d'historique (dont une en rupture), le test à un pas sur les mêmes 12 semaines passées a donné :
| Méthode | Erreur absolue moyenne |
|---|---|
| Moyenne mobile, 13 semaines | 1,885 |
| Lissage exponentiel, α 0,1 | 1,939 |
| Croston-SBA, α 0,1 | 1,971 |
| Moyenne mobile, 8 semaines | 2,000 |
| Moyenne mobile, 4 semaines | 2,000 |
| Dernière valeur | 3,667 |
La moyenne mobile sur 13 semaines l'emporte, avec une prévision constante de 10 unités par semaine. Remarquez ce qui n'est pas dans le tableau : la répétition saisonnière sur 52 semaines. Elle exige deux années complètes d'historique, soit 104 semaines, et cet article en compte 51 complètes. Un outil qui afficherait ici une « prévision saisonnière » inventerait un motif qu'il n'a jamais vu deux fois.
Deux règles garantissent l'équité. D'abord, une méthode n'est classée que si elle a pu être utilisée à chaque période de test ; si une moyenne mobile ne peut pas être calculée une semaine dont la fenêtre contient une rupture, elle n'obtient pas de note sur des semaines moins nombreuses et plus faciles. Ensuite, les égalités sont tranchées par une règle fixe (RMSE le plus faible, puis un ordre fixe) : réimporter le même fichier dans un autre ordre donne le même résultat.
Utiliser une erreur interprétable
L'erreur absolue moyenne (MAE) décrit la taille moyenne d'un écart en unités de demande : « on se trompe en général de 1,9 unité ». Le biais indique le sens des écarts : une prévision toujours trop haute remplit les rayons de trésorerie. Le RMSE pénalise davantage les gros écarts.
Les erreurs en pourcentage demandent de la prudence quand la demande réelle est nulle. L'erreur absolue en pourcentage pondérée (WAPE : somme des erreurs absolues divisée par la demande réelle totale) aide à comparer des articles de tailles différentes, mais si la demande réelle des semaines de test est nulle, le dénominateur manque. Un modèle ne doit pas afficher un 0 % rassurant faute de dénominateur ; la réponse honnête est « indisponible ».
Et soyez clair sur ce que mesure le test : c'est un test à un pas. Il dit si une méthode a bien prévu la semaine suivante à partir des précédentes, pas la précision d'une prévision à six mois.
Garder une plage de prévision honnête
Une bande ombrée autour d'une prévision rassure. Pour « Filtre A », les 10e et 90e centiles des 12 erreurs historiques à un pas valaient −2 et +2,14, ce qui place la semaine prochaine entre 8 et 12,1 unités environ. C'est un contexte utile, à condition de l'étiqueter : une plage historique de résidus à un pas, pas un intervalle de probabilité calibré pour une prévision à six mois. Avec moins de 8 erreurs de test, il y en a trop peu pour la calculer, et aucune bande ne doit apparaître.
Examiner ensuite le tampon
Le stock de sécurité est un modèle approché distinct. Ses hypothèses doivent être confirmées explicitement : demande et délai indépendants et non négatifs, paramètres suffisamment stables, approximation normale acceptable. Sous ces hypothèses, la variation de la demande comme celle du délai contribuent à l'incertitude sur la période de protection : le délai plus l'intervalle de revue.
Supposons une demande moyenne de dix unités par période avec un écart-type de deux, un délai moyen de trois périodes avec un écart-type de un, et une revue continue :
- Périodes de protection : T = 3 + 0 = 3
- Variance : V = T·s² + μ²·sL² = 3 × 2² + 10² × 1² = 12 + 100 = 112
- Écart-type : σ = √112 ≈ 10,583
- Avec un service par cycle de 95 %, z = 1,644853627, donc z·σ ≈ 17,41, arrondi à l'unité supérieure : stock de sécurité de 18
Avec une prévision constante de 10 unités, la demande attendue sur les 3 périodes de protection est de 30, et le stock cible vaut 30 + 17,41 arrondi au supérieur, soit 48.
Regardez d'où vient la variance : 12 des 112 proviennent de la demande hebdomadaire, 100 du délai incertain. Raccourcir ou fiabiliser les livraisons aide souvent davantage le tampon que n'importe quelle méthode de prévision.
Deux détails pratiques. Si le délai est saisi en jours alors que l'historique est hebdomadaire, convertissez d'abord les jours en semaines (18 jours font 2,57 semaines), puis seulement arrondissez la période de protection au supérieur : 2,57 semaines de délai plus une semaine de revue donnent 4 semaines de protection, et le résultat doit signaler l'arrondi. Pour les articles vendus au poids ou au volume, le tampon s'arrondit au pas réellement stocké, par exemple un demi-litre.
Chiffrer le tampon et trouver l'écart
Si la position de stock — en stock plus en commande moins commandes en attente — vaut 20 + 10 − 5 = 25, il manque 23 unités pour atteindre la cible. À 4 $ l'unité, le tampon seul immobilise 72 $.
Une échelle d'objectifs de service rend l'arbitrage concret pour le même article :
| Service par cycle | Tampon | Stock cible | Capital immobilisé |
|---|---|---|---|
| 90 % | 14 | 44 | 56 $ |
| 95 % | 18 | 48 | 72 $ |
| 97,5 % | 21 | 51 | 84 $ |
| 99 % | 25 | 55 | 100 $ |
Passer de 95 % à 99 % coûte 28 $ de stock supplémentaires pour ce seul article. Sur un catalogue de quelques centaines d'articles répartis entre plusieurs établissements, c'est la discussion à mener chiffres à l'appui.
Il s'agit d'un résultat de planification fondé sur des hypothèses, pas d'une commande ni d'une garantie de taux de service quantitatif. « 95 % de service par cycle » signifie qu'environ 95 % des cycles de réapprovisionnement devraient se terminer sans rupture sous les hypothèses indiquées — pas que 95 % des unités seront livrées.
En résumé
Prévision de la demande et stock de sécurité garde liés la prévision, le test historique et l'économie du tampon. Sa démo fixe présente un petit catalogue et un exemple de taille moyenne sur plusieurs établissements : 240 articles dans 4 établissements sur 104 semaines, chacun avec sa propre méthode testée et le capital des tampons totalisé par devise. Pour la question suivante — conditionnements, minimums de commande et budget d'achat limité —, utilisez Stock Purchase Planner.
Ouvrir la démo de Prévision de la demande et stock de sécurité
Outils cités dans ce guide
 Outil interactif
Prévision de la demande et stock de sécurité
Prévoyez la demande avec des méthodes statistiques transparentes, vérifiez les erreurs des prévisions passées et comparez le coût en trésorerie d'un stock de sécurité.

